
ANÁLISE DE PAPER
Um paper do ICCV 2025 usa imagens geradas para corrigir o desbalanceamento de classes de cauda longa — e obtém ganhos reais nas classes que os modelos costumam ignorar. Ele também esbarra exatamente no limite que mais nos interessa: a difusão gera imagens plausíveis, não imagens especificadas.
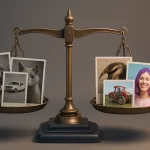
Modelos de visão computacional aprendem muito sobre o que veem com frequência — e muito pouco sobre o que veem raramente. Esse é o problema da distribuição de cauda longa: algumas classes têm milhares de exemplos, enquanto outras aparecem poucas vezes em todo o dataset. O modelo não falha porque foi mal construído. Falha porque os dados nunca insistiram.
O que o SynBalance faz
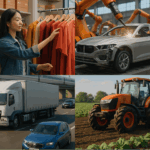
O SynBalance é um pipeline que combina dados reais e sintéticos para melhorar o desempenho em datasets desbalanceados. A ideia é simples e poderosa: gerar imagens adicionais apenas para as classes que não têm exemplos suficientes — e fazer isso de forma inteligente, ajustando não só a quantidade, mas também a diversidade e a clareza do que é gerado.
Os autores usaram modelos de difusão como o Stable Diffusion v1.5 para criar novas imagens a partir de prompts de texto. As amostras geradas são então analisadas e selecionadas segundo quatro critérios:
- Diversidade — o quanto as imagens sintéticas diferem entre si
- Reconhecibilidade — a facilidade com que um modelo identifica o que está vendo
- Gap de domínio — a distância visual entre as amostras sintéticas e as reais
- Quantidade — quantas amostras novas cada classe realmente precisa
Esse processo de seleção adaptativa produz um dataset “balanceado”, misturando imagens reais e sintéticas. Em benchmarks como ImageNet-LT e iNaturalist, o método superou várias baselines e trouxe ganho mensurável nas classes de cauda longa — as que os modelos normalmente ignoram.
Mas tem uma ressalva importante
Os próprios autores são transparentes quanto a isso. As imagens sintéticas vieram do Stable Diffusion v1.5 — um modelo generativo de propósito geral, feito para arte e ilustração, não para datasets científicos ou de machine learning.
Então, embora o SynBalance tenha entregado melhorias reais, qualidade e realismo das imagens continuaram sendo um limite. Algumas amostras geradas não tinham fidelidade visual, o que limitou o ganho. E pipelines generativos tendem a ser caros e imprevisíveis: não dá para especificar por completo o que cada imagem vai conter.
O conceito é excelente. O método de geração ainda tem espaço para melhorar — e é justamente aí que está a parte interessante.
O que muda se os dados vêm de uma cena controlada
Agora imagine o mesmo pipeline com simulação por trás, em vez de difusão. Não uma distribuição de onde se amostra, mas uma cena que se declara — com iluminação, materiais, posições de câmera, classes de objetos e suas frequências como entradas explícitas. Isso te daria:
- Imagens fotorrealistas e internamente consistentes, sem artefatos de geração
- Balanceamento de classes exato, porque o número de exemplos por classe é uma entrada
- Anotações produzidas automaticamente e com exatidão — caixas, máscaras, labels de instância, profundidade e até bandas espectrais
- Reprodutibilidade: os mesmos parâmetros de cena renderizam o mesmo dataset duas vezes
Essa é a diferença entre pedir a um modelo que imagine um tigre e construir um tigre que você pode posicionar, iluminar e fotografar sob demanda. É também a distinção que o SynBalance aponta sem conseguir realizar: o próximo passo é sair do gerado por IA para o controlado por projeto.
O que o paper realmente ensina
A mensagem clara é que dados sintéticos funcionam e que, usados com propósito, são uma ferramenta séria contra os limites dos datasets do mundo real. A nuance — e a que vale levar para o seu projeto — é que o valor não está no volume de imagens geradas. Está em você controlar o que há nelas e conseguir provar o que há nelas.
Essa é a diferença entre uma imagem sintética e um dataset sintético.
Tem um problema de cauda longa no seu caso?
Conte quais classes estão falhando. Avaliamos se vale testar simulação controlada.
Agendar conversa →Visão computacional · Dados sintéticos · Análise de paper · Desbalanceamento de classes
Deixe um comentário