-
SynBalance: equilibrando classes raras com dados sintéticos
Um paper do ICCV 2025 usa imagens geradas para corrigir o desbalanceamento de classes de cauda longa — e esbarra no limite da difusão: imagens plausíveis, não especificadas.
-
Dados sintéticos em visão computacional: da revolução científica às aplicações industriais
Como os dados sintéticos saíram dos laboratórios e se tornaram base de aplicações comerciais: os marcos do Max Planck, o impacto em citações e os setores que ainda estão descobertos.
-
ROSE: remoção de objetos em vídeos com dados sintéticos 3D
O ROSE treina um modelo de remoção de objetos em vídeo apenas com dados sintéticos 3D — e mostra por que o mundo real não consegue fornecer pares com e sem o objeto.
-
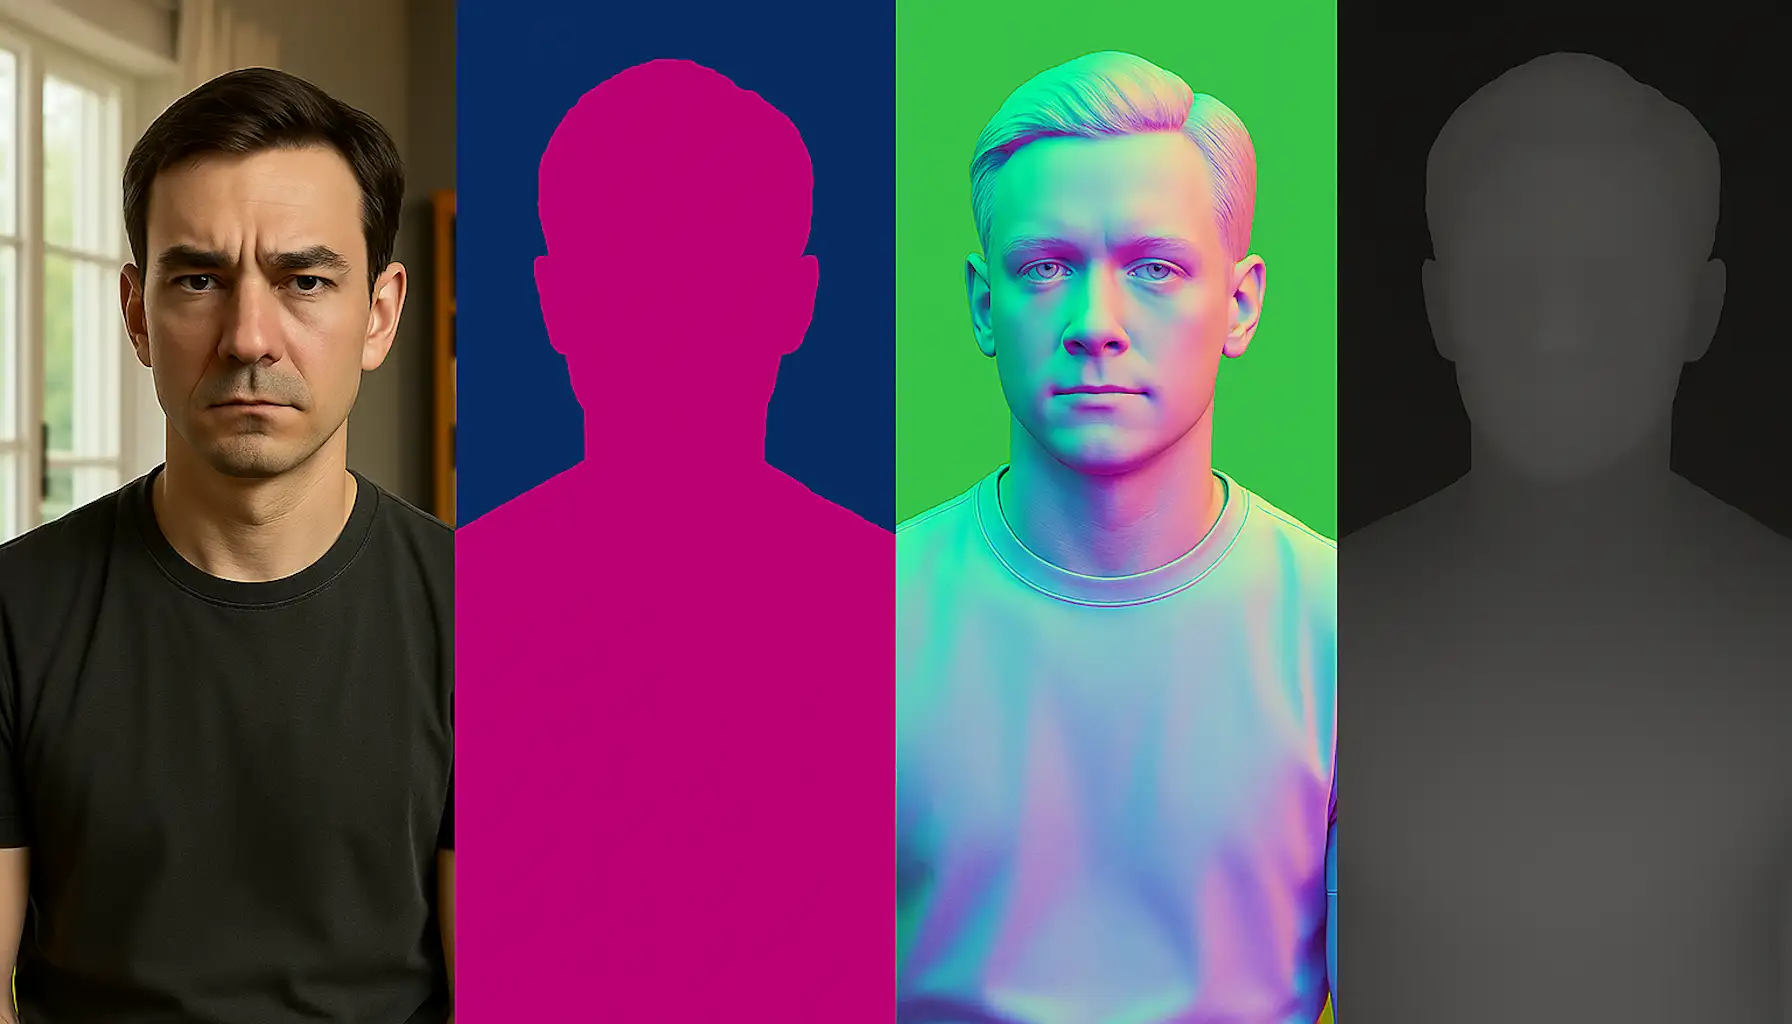
DAViD, da Microsoft: um marco público em visão computacional com dados sintéticos
O DAViD, da Microsoft, foi treinado apenas com dados sintéticos — e iguala ou supera modelos treinados com imagens reais. Código, dataset e modelos são públicos.
-
A IA está “desligando” nosso cérebro? Uma reflexão além do hype
O estudo do MIT virou manchete como se a IA estivesse “desligando” o cérebro. O que o paper realmente mostrou — e por que a discussão é sobre critério, não pânico.
-
O colapso da “IA fantasma”: o que Builder.ai e Amazon ensinam — e por que a SynthVision é diferente
Builder.ai e Amazon Go mostraram que muita “IA” depende de trabalho humano escondido. Por que isso não escala — e como dados sintéticos mudam a base do problema.
-
Como dados sintéticos viabilizam a reconstrução 4D de cenas: lições do paper Geo4D
O Geo4D reconstrói cenas 4D a partir de vídeo monocular treinando só com dados sintéticos — e generaliza para vídeos reais sem nenhum ajuste.
-

O futuro da IA está nos dados sintéticos — e as big techs já sabem disso
Nvidia, Google e OpenAI já tratam dados sintéticos como infraestrutura: por que a escassez de dados reais virou o gargalo da IA e o que muda no treinamento de modelos.
// reading
Blog: dados sintéticos e visão computacional
ArquivoArchive
CategoriasCategories
Posts recentesRecent Posts
- SynBalance: equilibrando classes raras com dados sintéticos
- Dados sintéticos em visão computacional: da revolução científica às aplicações industriais
- ROSE: remoção de objetos em vídeos com dados sintéticos 3D
- DAViD, da Microsoft: um marco público em visão computacional com dados sintéticos
- A IA está “desligando” nosso cérebro? Uma reflexão além do hype