
Quando o assunto é visão computacional e dados sintéticos, costumamos ver pesquisas fechadas — aplicadas a contextos proprietários e longe do acesso público. Por isso o recente projeto DAViD (Data-efficient and Accurate Vision models from synthetic Data), apresentado pela Microsoft no ICCV 2025, chama atenção: ele foi totalmente liberado ao público, incluindo código, dataset e modelos.
O projeto destaca algo que nós, da SynthVision, conhecemos bem: dados sintéticos de alta qualidade podem treinar modelos de visão completos, eficientes e precisos — sem depender de imagens reais.
O que é o DAViD?
O DAViD é um sistema de visão computacional multitarefa baseado em arquitetura transformer, treinado inteiramente com dados sintéticos. O nome é uma homenagem dupla: à escultura de Michelangelo — símbolo de precisão anatômica — e à ideia clássica de Davi contra Golias, com um modelo pequeno encarando desafios gigantes.
A Microsoft desenvolveu o DAViD com um dataset sintético proprietário chamado SynthHuman, composto por aproximadamente 300.000 imagens altamente realistas de cabeças, troncos e corpos humanos completos.
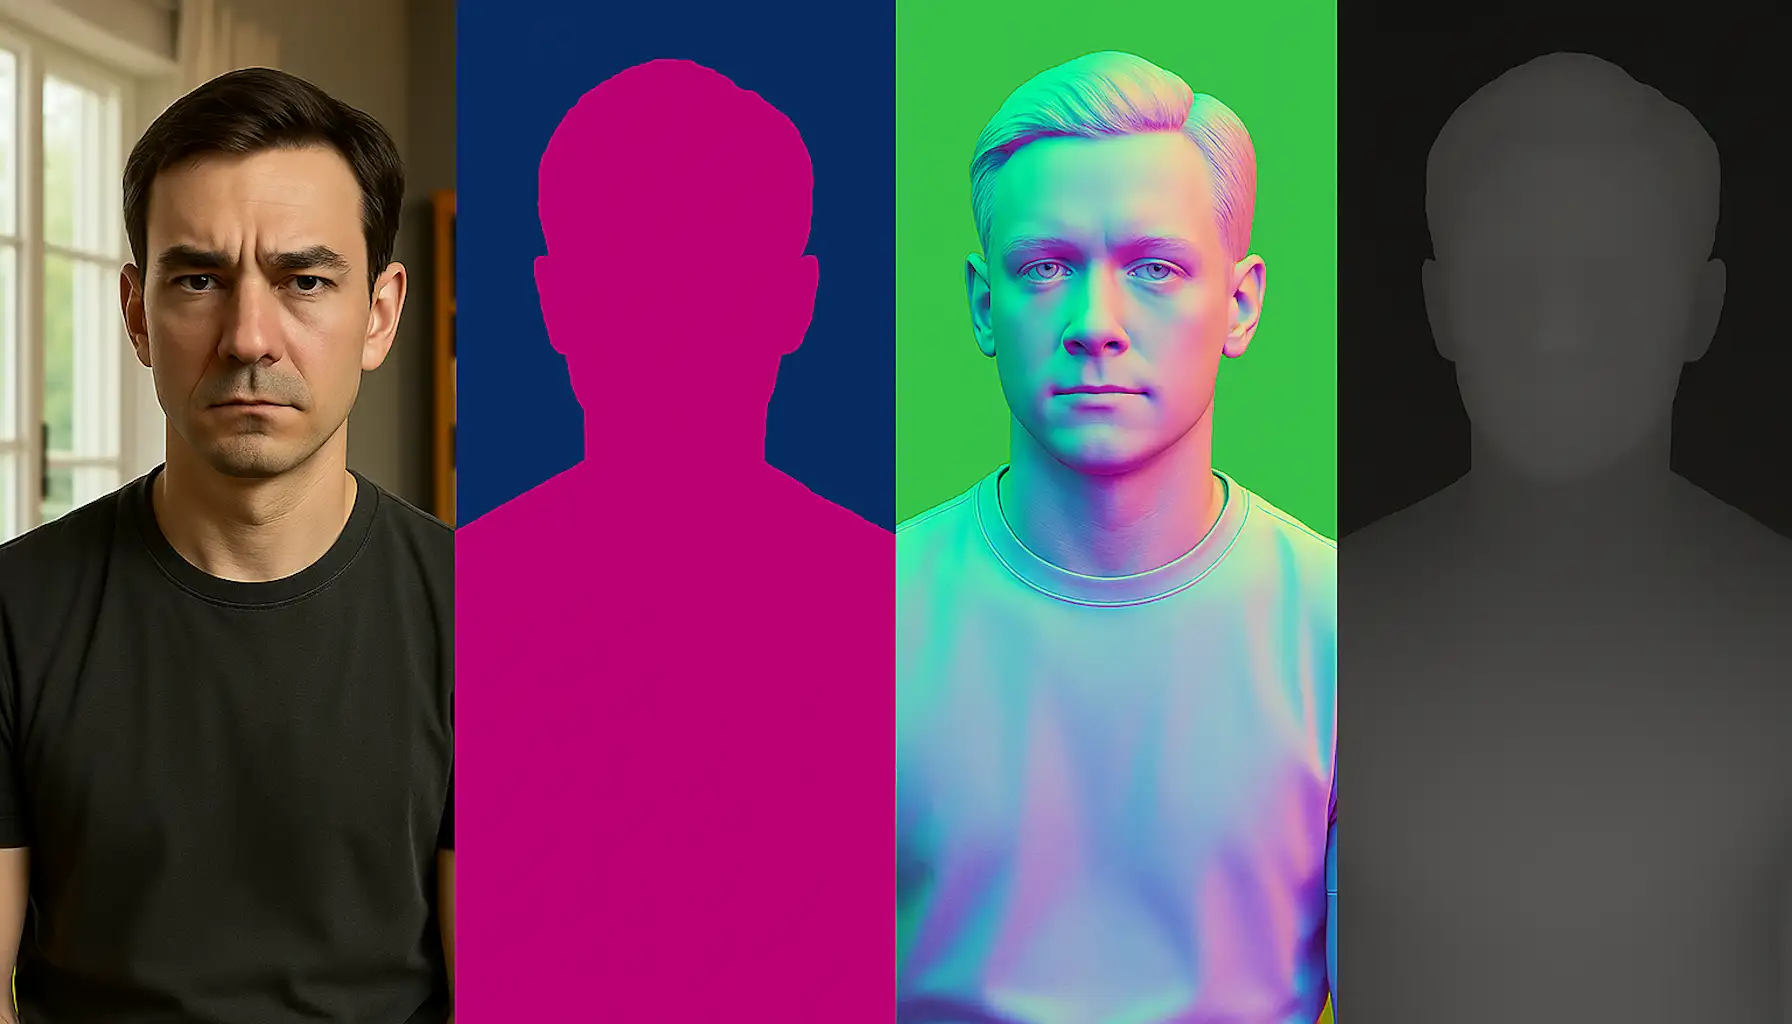
Essas imagens vêm ricamente anotadas com:
- Máscara alpha (segmentação de primeiro plano)
- Mapa de profundidade
- Normais de superfície
- Parâmetros de câmera
E tudo isso com custo zero de anotação manual — algo possível apenas em ambientes sintéticos.
Um modelo compacto, multitarefa e eficiente
O modelo DAViD se baseia na arquitetura Dense Prediction Transformer (DPT) e foi treinado para prever simultaneamente:
- Máscara de primeiro plano
- Profundidade
- Normais de superfície
Em outras palavras, a partir de uma única imagem o modelo executa várias tarefas visuais de forma coerente e coordenada. Isso não só reduz a necessidade de treinar e manter modelos separados, como também permite inferência mais rápida — apenas 21 ms por quadro em uma GPU A100.
Mais importante: todo esse desempenho foi alcançado usando apenas dados sintéticos. Nenhuma imagem real foi usada no treinamento.
Resultados no mundo real — sem nenhuma supervisão real
Talvez o aspecto mais impressionante do DAViD seja seu desempenho em imagens reais, mesmo tendo sido treinado exclusivamente com sintéticas. A Microsoft avaliou o modelo em dois datasets reais — Goliath e Hi4D — e os resultados foram notáveis.
O paper também apresenta várias tabelas comparativas mostrando o desempenho do DAViD frente a modelos treinados com datasets reais como THuman2.0 e RenderPeople. Em tarefas como estimativa de profundidade, normais de superfície e segmentação suave, o DAViD iguala ou supera modelos estado da arte — com arquitetura mais compacta e inferência mais rápida.
Isso oferece evidência pública e verificável de que dados sintéticos de alta qualidade podem ser a única fonte de treinamento de modelos que performam muito bem em entradas do mundo real.
O poder dos dados sintéticos — quando bem aplicados
Para quem trabalha com dados sintéticos há anos, o DAViD é um exemplo público do que vivemos na prática: quando você controla cada aspecto da cena — câmera, iluminação, textura, geometria, profundidade, ruído — consegue construir datasets incrivelmente ricos, balanceados e anotados com precisão.
O resultado é um treinamento mais direto, livre de vieses escondidos, com poder de generalização surpreendente. Isso é especialmente valioso para tarefas como:
- Segmentação precisa
- Estimativa de profundidade
- Detecção ou reconstrução 3D
- Treinamento de robôs ou agentes simulados
Capturar esse nível de anotação no mundo real seria caro, lento e, muitas vezes, inviável.
As big techs estão mostrando o caminho
O DAViD não está sozinho. Cada vez mais gigantes da tecnologia publicam pesquisas construídas sobre o uso intensivo de dados sintéticos:
- A Meta usou imagens sintéticas para treinar o SAM-2, seu modelo de segmentação de instâncias de nova geração.
- O Grok, do X (antigo Twitter), foi treinado com volumes massivos de dados sintéticos em tarefas de linguagem.
- E agora a Microsoft, com o DAViD, apresenta um estudo totalmente aberto focado em visão computacional.
Vale notar: o fato de essas empresas publicarem esse tipo de trabalho agora não significa que começaram a explorar dados sintéticos há pouco — significa que já os usam intensamente há anos e só agora tornam pública uma pequena parte disso.
Estamos no caminho certo
Na SynthVision, desenvolvemos datasets sintéticos de alta fidelidade com controle total sobre o conteúdo da cena — incluindo iluminação, material, geometria e sensores (câmeras RGB, profundidade, hiperespectral), além de todos os parâmetros envolvidos no pipeline de renderização.
Nosso foco é ajudar empresas a acelerar a experimentação, viabilizar tarefas complexas com poucos dados reais e entregar modelos robustos já na fase de POC.
Enquanto muitos dos nossos melhores resultados seguem em projetos privados, trabalhos públicos como o DAViD mostram que o caminho dos dados sintéticos é mais sólido do que nunca — e quem domina isso agora está bem posicionado para liderar a próxima onda de avanços em visão computacional.
Quer ver como dados sintéticos podem acelerar seu projeto? Na SynthVision, construímos datasets sintéticos sob medida, prontos para pipelines reais — com qualidade fotorrealista, anotações precisas e entrega rápida.
Deixe um comentário