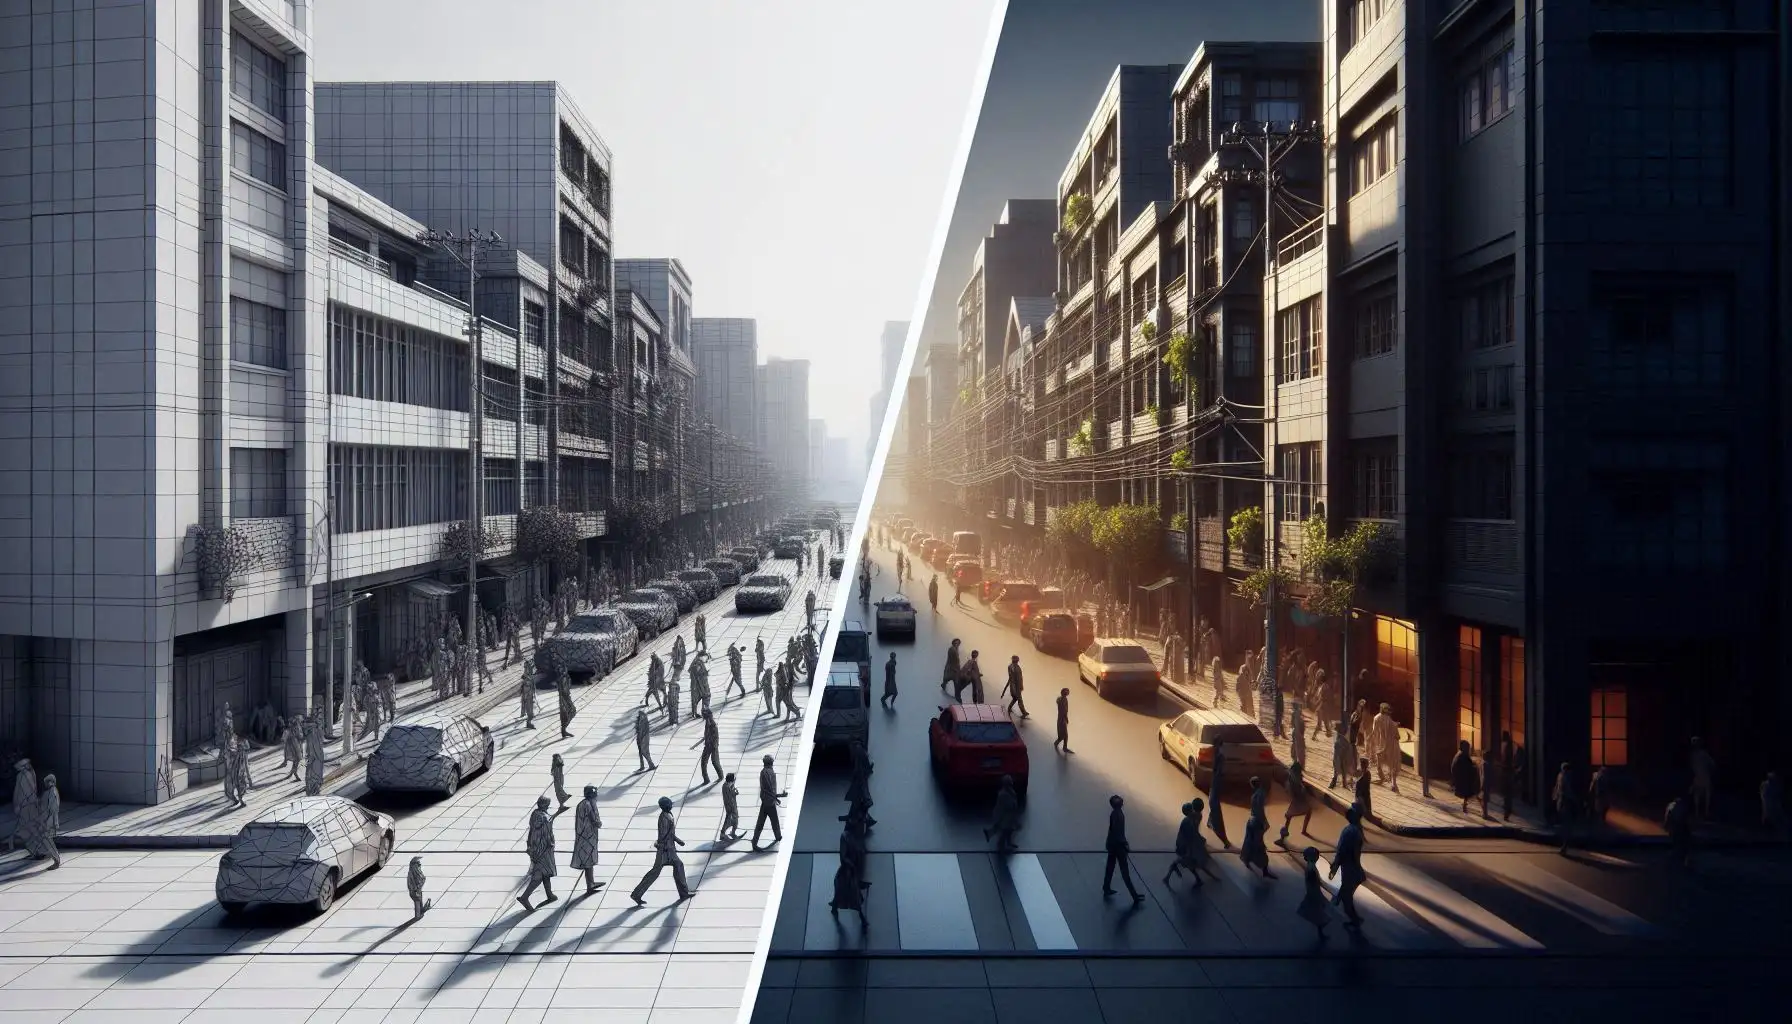

O artigo “Dataset Augmentation with Synthetic Images Improves Semantic Segmentation” demonstra como dados sintéticos podem elevar o desempenho de modelos de segmentação semântica. Mas ele também evidencia as limitações de imagens não fotorrealistas geradas no Blender. Neste post, analisamos a metodologia do paper e a comparamos com os datasets sintéticos hiper-realistas da SynthVision, que superam essas limitações e abrem novas possibilidades em diversos setores.
Comparando as abordagens: artigo vs. SynthVision
| Aspecto | Artigo (Blender + CRF) | SynthVision |
|---|---|---|
| Qualidade da imagem | Não fotorrealista, com texturas e iluminação limitadas. | Cenas hiper-realistas com texturas e materiais detalhados. |
| Controle do ambiente | Controle básico com Blender, variedade limitada de fundos e iluminação. | Personalização abrangente de objetos, materiais, iluminação e ângulos de câmera. |
| Escalabilidade | 100 imagens sintéticas por classe, com modelos limitados. | Datasets em larga escala, sob medida para as necessidades de cada cliente e setor. |
| Qualidade da anotação | Usa CRF/GrabCut, sujeito a bordas com ruído. | Anotações totalmente automatizadas com precisão em nível de pixel. |
| Geração de cenários | Fundos estáticos do SUN Database. | Cenas dinâmicas: múltiplos objetos e condições de iluminação diversas. |
| Transferência para dados reais | Tem dificuldade com classes de alta variabilidade (como pessoas e animais). | Transição suave do sintético para aplicações reais, melhorando a generalização. |
Principais vantagens da abordagem da SynthVision
- Renderizações fotorrealistas: ao contrário do artigo, que trabalha com saídas simplistas do Blender, os datasets hiper-realistas da SynthVision imitam melhor as condições reais, reduzindo o gap de domínio.
- Melhor transferibilidade dos modelos: com pistas visuais mais ricas (texturas, iluminação), modelos treinados com dados da SynthVision generalizam com mais eficácia para tarefas reais, resolvendo os desafios apontados no artigo.
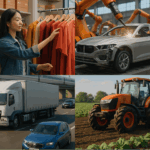
- Datasets flexíveis e escaláveis: os datasets da SynthVision não se limitam a classes predefinidas de objetos; atendem a setores específicos como veículos autônomos, agricultura, indústria 4.0 e saúde.
- Redução do custo de anotação: anotações automáticas e livres de ruído eliminam a necessidade de pós-processamento com ferramentas como CRF, citada no artigo.
Uma solução pronta para o futuro do desenvolvimento de IA
O artigo mostra o poder do aumento de dataset com dados sintéticos, mas também revela fragilidades em realismo das imagens e variedade de datasets. A SynthVision oferece uma solução para esses problemas com geração de dados sintéticos hiper-realistas e altamente controlados, reduzindo o custo de anotação e melhorando o desempenho da segmentação.
Para desenvolvedores e pesquisadores de IA, o uso combinado de dados reais e sintéticos hiper-realistas representa o futuro. Seja em segmentação semântica, detecção de objetos ou imagens hiperespectrais, os datasets da SynthVision garantem dados de treinamento confiáveis, escaláveis e precisos.
Conclusão
Enquanto o artigo apresenta uma prova de conceito sólida, a SynthVision leva o aumento de dataset a outro patamar, atacando as limitações centrais da geração tradicional de dados sintéticos. Ao usar hiper-realismo e controle preciso, a SynthVision capacita empresas e pesquisadores a construir modelos mais robustos e a acelerar a inovação em IA.
Deixe um comentário