
Uma análise do estudo do MIT
No campo da visão computacional, a geração de dados sintéticos surgiu como solução eficiente para treinar modelos de machine learning. Um estudo de 2022 do MIT apresentou uma técnica inovadora que usa IA generativa para criar dados sintéticos altamente realistas. Embora revolucionário na época, esse estudo hoje serve como um caso que evidencia limitações inerentes à IA generativa — limitações que podem ser superadas por abordagens de simulação controlada. Neste post, analisamos o estudo do MIT e mostramos como a geração de dados sintéticos por simulação oferece vantagens significativas.
Dados sintéticos que superam dados reais
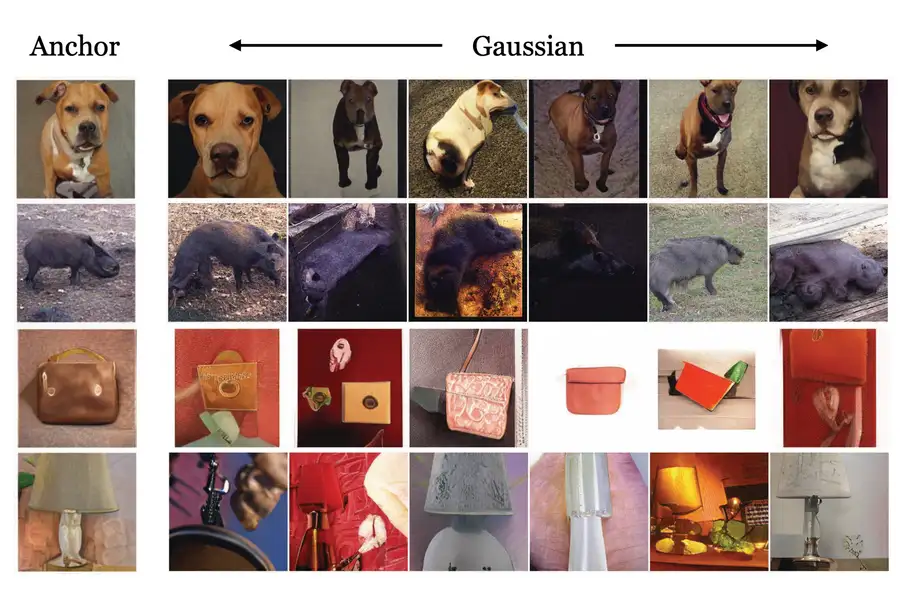
No estudo do MIT, os pesquisadores descobriram que um modelo de aprendizado contrastivo treinado exclusivamente com dados sintéticos foi capaz de “aprender representações visuais que rivalizam ou até superam as aprendidas com dados reais”. Isso demonstra o poder dos dados sintéticos para modelos de visão computacional.
“Seus resultados mostram que um modelo de aprendizado de representação contrastiva, treinado apenas com esses dados sintéticos, é capaz de aprender representações visuais que rivalizam ou até superam as aprendidas com dados reais.”
Essa afirmação destaca o impacto que dados sintéticos podem ter na criação de representações visuais eficazes. No entanto, enquanto o MIT depende da melhoria gradual dos modelos de IA generativa, nossa abordagem baseada em simulação entrega resultados superiores desde o início, porque temos controle total sobre cada aspecto da cena.
Dependência de imagens reais
O processo de treinamento dos modelos generativos descrito no estudo envolve expô-los a milhões de imagens reais para gerar novos dados sintéticos. Essa dependência de grandes volumes de imagens reais pode ser um gargalo em muitos cenários.
“O processo de treinamento envolve mostrar ao modelo generativo milhões de imagens que contêm objetos de uma determinada classe (como carros ou gatos)…”
Em contraste, nossa abordagem de simulação não depende de imagens reais. Criamos as imagens necessárias diretamente, com base total em simulação. Isso elimina a necessidade de grandes datasets reais e permite gerar dados do zero, sem restrições.
Controle total vs. a “imaginação” dos modelos generativos
O estudo também menciona que modelos generativos podem “imaginar” objetos em situações diferentes, mas essa imaginação pode levar a incertezas e erros imprevisíveis.
“Se o modelo é treinado com imagens de carros, ele pode ‘imaginar’ como um carro seria em diferentes situações…”
Embora essa “imaginação” possa ser útil em alguns casos, ela pode resultar em dados irreais ou inconsistentes. Com simulação completa, temos controle total sobre todos os parâmetros, como poses, cores e tamanhos, garantindo que os dados gerados sigam sempre regras físicas e sejam precisos e relevantes.
Privacidade e dados sensíveis
O estudo do MIT também alerta que modelos generativos podem revelar dados de origem, gerando possíveis preocupações de privacidade e amplificação de vieses.
“Esses modelos podem revelar dados de origem, o que pode gerar riscos de privacidade, e podem amplificar vieses…”
A simulação, por outro lado, não carrega esses riscos. Como os dados são totalmente simulados, não há dados sensíveis envolvidos, o que traz segurança adicional para setores como a saúde, onde a privacidade dos dados é essencial.
Casos extremos e cenários incomuns
Outro ponto interessante do estudo é a menção a “casos de canto”, ou situações extremas difíceis de capturar com dados reais, mas que podem ser geradas sinteticamente para melhorar os modelos.
“Por exemplo, se pesquisadores estão treinando um modelo de visão computacional para um carro autônomo, dados reais não conteriam exemplos de um cachorro e seu dono correndo por uma rodovia…”
Em simulação, podemos criar esses cenários raros ou extremos de forma controlada e precisa. Isso garante que os modelos sejam treinados para lidar com situações incomuns que não existem nos datasets reais.
Conclusão
Embora o estudo do MIT de 2022 tenha sido revolucionário, ele também revela limitações da IA generativa, como a dependência de imagens reais, riscos de privacidade e a “imaginação” restrita dos modelos. Na SynthVision, a simulação completa oferece uma solução superior, com controle total sobre cada cenário, sem risco de dados sensíveis ou vieses e com capacidade de criar casos extremos com precisão. Por isso, a simulação se destaca como a abordagem mais eficiente e segura para a geração de dados sintéticos em diversas aplicações de visão computacional.
Deixe um comentário